통화 기록 증분 동기화: updatedAfter 커서로 빠짐없이 가져오기
KAT Cloud 통화 기록은 GET /call-history에 updatedAfter를 넘겨 갱신된 것만 가져옵니다. 마지막 updatedAt을 다음 커서로 쓰는 규칙, offset과 섞으면 안 되는 이유, SQLite에 저장하는 Python 스크립트를 정리했습니다.
KAT Cloud 통화 기록 증분 동기화는 GET /call-history에 updatedAfter를 넘겨 그 시각 이후 갱신된 기록만 받는 방식입니다. updatedAfter를 지정하면 응답이 updatedAt 오름차순으로 정렬되므로, 응답 마지막 항목의 updatedAt을 다음 요청의 updatedAfter로 넘기는 커서처럼 쓰면 됩니다. 이 글은 그 규칙과 함께 그룹별 커서를 저장하며 SQLite에 쌓는 Python 스크립트를 소개합니다.
전체 조회 대신 증분 조회를 쓰는 이유
KAT Cloud(캣클라우드) API 문서는 새 통화를 주기적으로 확인할 때 전체 목록을 반복해서 조회하지 말라고 안내합니다. 통화 기록에는 요약과 STT 대화 내역이 함께 들어 있어 응답 하나가 수백 KB에 달할 수 있고, 매번 처음부터 순회하면 양쪽 모두에 부담이 큽니다. 문서가 권장하는 방법은 두 가지입니다.
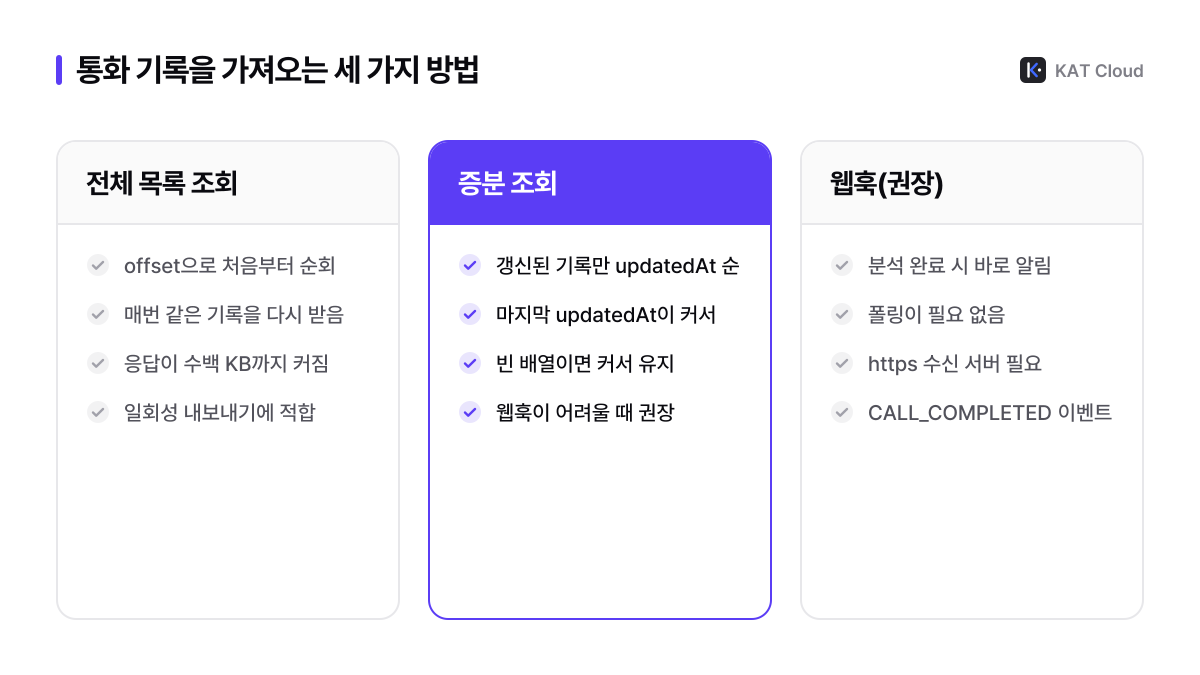
웹훅이 가장 좋지만, 외부에서 접근 가능한 https 서버를 둘 수 없거나 데이터 웨어하우스로 정해진 주기마다 옮기는 배치 작업이라면 증분 조회가 맞습니다. 웹훅을 쓰더라도 서버 장애로 놓친 이벤트를 대조하는 안전망으로 증분 조회를 함께 돌리면 좋습니다. 웹훅 쪽 설계는 폴링 대신 웹훅에서 다룹니다.
GET /call-history 파라미터와 응답 구조
GET /call-history는 그룹 단위로 통화 기록 목록을 조회합니다.
| 파라미터 | 필수 | 설명 |
|---|---|---|
groupId | 필수 | 그룹 ID |
channelId | 선택 | 채널 ID(미입력 시 그룹 전체) |
phoneNumber | 선택 | 전화번호 검색(발신·수신 번호) |
keyword | 선택 | 통화 요약 내용 검색 |
updatedAfter | 선택 | 이 시각 이후 갱신된 기록만 조회(ISO 8601). 지정하면 updatedAt 오름차순 |
offset | 선택 | 시작 인덱스(기본 0) |
limit | 선택 | 조회 개수(기본 20, 최대 100) |
응답은 data 배열과 total, offset, limit으로 구성됩니다. data의 각 항목에는 아래 필드가 들어 있습니다.
| 필드 | 설명 |
|---|---|
callHistoryId | 통화 기록 ID(문자열). 저장 시 기본 키로 씁니다. |
fromNumber, toNumber, isInbound | 발신·수신 번호와 수신 통화 여부 |
status | ANSWERED, MISSED, REJECTED, UNKNOWN |
tag | AI, DIRECT, AI_TO_DIRECT, UNKNOWN |
duration | 통화 시간(초) |
summary, sttAI, sttDirect | 통화 요약과 AI 구간·직원 구간 STT(role, text, timestamp) |
recordingAI, recordingDirect | 녹음 파일(url, expiresAt, contentLength, contentType) |
isRecorded | false면 녹음·요약·STT가 제공되지 않음 |
channelId, groupId, createdAt, updatedAt | 소속과 생성·갱신 시각 |
요약과 STT 배열을 어떻게 읽는지는 통화 받아쓰기와 요약 데이터 구조에서 자세히 설명합니다.
updatedAfter 커서 규칙 네 가지
증분 조회는 아래 네 가지만 지키면 됩니다.
- 1
updatedAfter를 지정하면 그 시각 이후 갱신된 기록만updatedAt오름차순으로 옵니다. - 2응답 마지막 항목의
updatedAt을 다음 요청의updatedAfter로 그대로 넘깁니다. - 3
data가 빈 배열이면 새로 갱신된 기록이 없다는 뜻입니다. 커서를 그대로 두고 다음 주기에 다시 호출합니다. - 4
offset과 함께 쓰지 않습니다. 조회 도중 갱신된 항목이 순서에 끼어들어 누락이 생길 수 있습니다.
# 1) 최초 조회: 기준 시각부터
GET /call-history?groupId=1&updatedAfter=2026-03-12T00:00:00.000Z&limit=100

# 2) 마지막 항목의 updatedAt이 2026-03-12T02:47:13.000Z였다면 그 값을 그대로 넘긴다
GET /call-history?groupId=1&updatedAfter=2026-03-12T02:47:13.000Z&limit=100curl -G "https://studio-gateway.zerocall.kr/call-history" \
-H "x-api-key: $KAT_API_KEY" \
--data-urlencode "groupId=1" \
--data-urlencode "updatedAfter=2026-03-12T02:47:13.000Z" \
--data-urlencode "limit=100"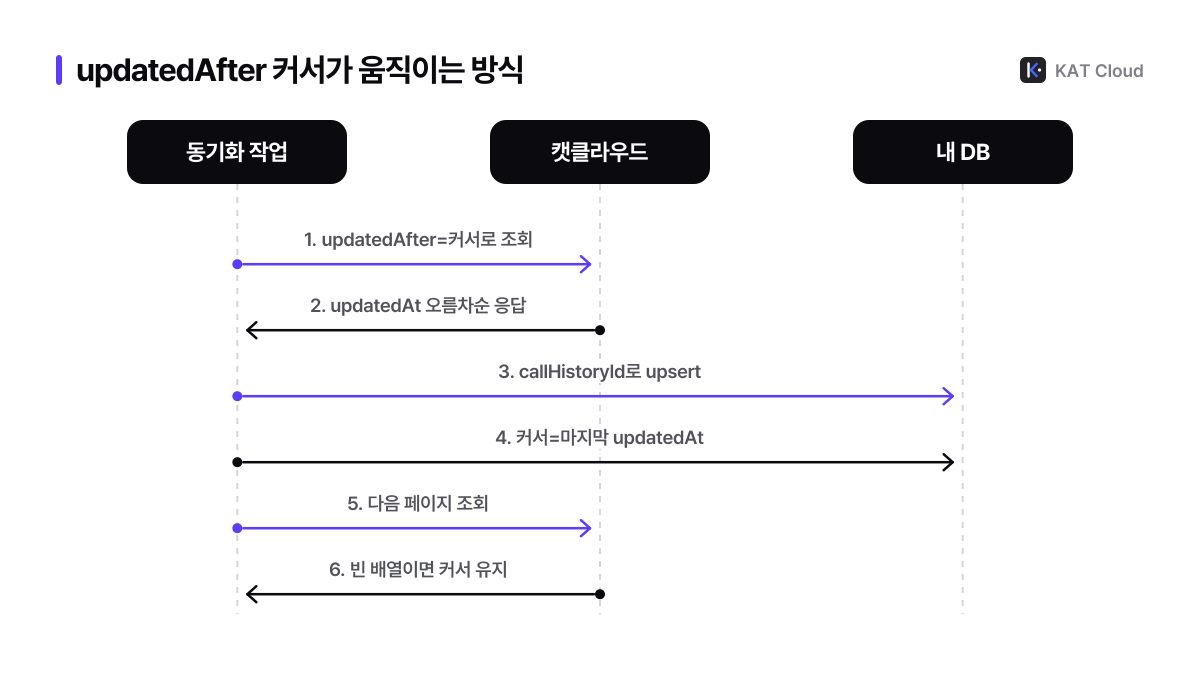
updatedAt이 언제 바뀌는지도 알아 두어야 합니다. KAT Cloud는 녹음 파일이 저장되는 순간이 아니라 STT·요약 처리가 끝나 통화 기록이 저장되는 시점에 updatedAt을 갱신합니다. 그래서 증분 조회로 잡히는 기록은 녹음 결과가 준비된 통화이고, 이때 summary, sttAI, recordingAI가 함께 채워져 있습니다. 통화가 끝난 직후를 알아야 한다면 증분 조회 대신 웹훅을 씁니다.
Python 증분 동기화 스크립트
아래 스크립트는 API 키로 접근 가능한 그룹마다 커서를 따로 두고, 받은 기록을 SQLite에 upsert합니다. 기록 저장과 커서 갱신을 한 트랜잭션으로 묶어, 중간에 프로세스가 죽어도 다시 실행하면 마지막으로 커밋된 지점부터 이어집니다.
"""KAT Cloud 통화 기록 증분 동기화 (updatedAfter 커서)

실행: KAT_API_KEY=... python sync_call_history.py --once
"""
import argparse
import json
import os
import random
import sqlite3
import time

import requests

BASE_URL = "https://studio-gateway.zerocall.kr"
PAGE_SIZE = 100                                # limit 최대값
POLL_INTERVAL = 60                             # 새 기록이 없을 때 다음 주기까지 대기(초)
INITIAL_CURSOR = "2026-10-01T00:00:00.000Z"    # 처음 실행할 때의 기준 시각
DB_PATH = "call_history.db"

session = requests.Session()
session.headers.update({"x-api-key": os.environ["KAT_API_KEY"]})


def api_get(path, params=None, max_retries=5):
    for attempt in range(max_retries + 1):
        resp = session.get(BASE_URL + path, params=params, timeout=30)
        if resp.status_code == 429 or resp.status_code >= 500:
            if attempt == max_retries:
                resp.raise_for_status()
            time.sleep(min(60, 2 ** attempt) + random.random())  # 지수 백오프 + 지터
            continue
        if not resp.ok:
            raise RuntimeError(f"{resp.status_code} {resp.text}")
        body = resp.json()
        # 공통 성공 응답 {"code": "0", "message": "Success", "result": ...}
        return body["result"] if isinstance(body, dict) and "result" in body else body


def open_db(path):
    db = sqlite3.connect(path)
    db.executescript("""
    CREATE TABLE IF NOT EXISTS call_history (
        call_history_id TEXT PRIMARY KEY,
        group_id INTEGER, channel_id INTEGER,
        from_number TEXT, to_number TEXT, is_inbound INTEGER,
        status TEXT, tag TEXT, duration INTEGER,
        summary TEXT, stt_ai TEXT, stt_direct TEXT, is_recorded INTEGER,
        created_at TEXT, updated_at TEXT
    );
    CREATE TABLE IF NOT EXISTS sync_cursor (
        group_id INTEGER PRIMARY KEY,
        updated_after TEXT NOT NULL
    );
    """)
    return db


def load_cursor(db, group_id):
    row = db.execute(
        "SELECT updated_after FROM sync_cursor WHERE group_id = ?", (group_id,)
    ).fetchone()
    return row[0] if row else INITIAL_CURSOR


def save_page(db, group_id, items):
    rows = [(
        it["callHistoryId"], it.get("groupId"), it.get("channelId"),
        it.get("fromNumber"), it.get("toNumber"), int(bool(it.get("isInbound"))),
        it.get("status"), it.get("tag"), it.get("duration"), it.get("summary"),
        json.dumps(it.get("sttAI") or [], ensure_ascii=False),
        json.dumps(it.get("sttDirect") or [], ensure_ascii=False),
        int(bool(it.get("isRecorded"))), it.get("createdAt"), it["updatedAt"],
    ) for it in items]
    with db:  # 기록 저장과 커서 갱신을 하나의 트랜잭션으로 커밋
        db.executemany("""
        INSERT INTO call_history VALUES (?,?,?,?,?,?,?,?,?,?,?,?,?,?,?)
        ON CONFLICT(call_history_id) DO UPDATE SET
            status = excluded.status, tag = excluded.tag,
            duration = excluded.duration, summary = excluded.summary,
            stt_ai = excluded.stt_ai, stt_direct = excluded.stt_direct,
            is_recorded = excluded.is_recorded, updated_at = excluded.updated_at
        """, rows)
        db.execute("""
        INSERT INTO sync_cursor (group_id, updated_after) VALUES (?, ?)
        ON CONFLICT(group_id) DO UPDATE SET updated_after = excluded.updated_after
        """, (group_id, items[-1]["updatedAt"]))


def sync_group(db, group_id):
    synced = 0
    while True:
        cursor = load_cursor(db, group_id)
        page = api_get("/call-history", {
            "groupId": group_id,
            "updatedAfter": cursor,
            "limit": PAGE_SIZE,
        })
        items = page["data"]
        if not items:
            return synced                      # 갱신된 기록 없음: 커서 유지
        save_page(db, group_id, items)
        synced += len(items)
        if len(items) < PAGE_SIZE:
            return synced                      # 마지막 페이지까지 받음
        if items[-1]["updatedAt"] == cursor:
            print(f"경고: group {group_id} 커서가 진행되지 않아 다음 주기에 재시도합니다.")
            return synced


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--once", action="store_true", help="한 번만 동기화하고 종료")
    args = parser.parse_args()

    db = open_db(DB_PATH)
    while True:
        for group in api_get("/group"):
            n = sync_group(db, group["id"])
            print(time.strftime("%H:%M:%S"), f"group {group['id']}: {n}건 반영")
        if args.once:
            break
        time.sleep(POLL_INTERVAL)


if __name__ == "__main__":
    main()
스크립트의 동작을 정리하면 다음과 같습니다.
GET /group으로 그룹 목록을 받아 그룹마다sync_group을 돌립니다.groupId가 필수 파라미터이므로 커서도 그룹별로 저장합니다.- 한 페이지가
limit(100건)만큼 꽉 차면 바로 다음 페이지를 요청하고, 덜 차거나 비어 있으면 그 그룹은 끝난 것으로 봅니다. - 429와 5xx 응답은 지수 백오프로 재시도합니다. 같은 키로 여러 작업이 돌면 1,200 requests / 60초 한도를 함께 나눠 쓴다는 점을 기억하세요.
- 저장은
callHistoryId기준 upsert입니다. 같은 기록이 다시 와도 최신 값으로 덮어쓸 뿐 중복 행이 생기지 않습니다.
운영할 때 챙길 점
경계 처리부터 보겠습니다. updatedAfter가 그 시각을 포함하는지(이상) 제외하는지(초과)는 문서에 명시되어 있지 않습니다. 포함이라면 마지막 기록이 한 번 더 올 수 있지만, upsert로 저장하므로 문제가 되지 않습니다. 같은 updatedAt을 가진 기록이 한 페이지를 넘게 몰려 커서가 움직이지 않는 드문 경우를 위해 스크립트에 경고 분기도 넣어 두었습니다.
녹음 URL은 저장하지 않습니다. recordingAI와 recordingDirect의 url은 S3 Presigned URL이고 1시간 뒤 만료되므로, DB에 넣어 두면 나중에 열리지 않습니다. 파일이 필요하면 동기화 직후 내려받아 별도 저장소에 보관합니다. 방법은 통화 녹음 파일 내려받기에 정리했습니다.
그 밖에 확인할 항목은 다음과 같습니다.
- 처음 실행할 때의
INITIAL_CURSOR는 보관이 필요한 가장 오래된 시점으로 잡습니다. 과거 기록을 한 번에 옮기는 일회성 내보내기라면offset·limit과 응답의total을 쓰는 전체 조회가 더 단순할 수 있습니다. - 동기화 주기는 업무에 필요한 신선도에 맞춥니다. 몇 분 단위면 충분한 대시보드와 통화 직후 반응해야 하는 자동화는 요구가 다르고, 후자는 웹훅이 맞습니다.
- 에러가 계속되면 상태 코드별로 다르게 대응합니다. 401·403은 재시도해도 풀리지 않으므로 알림을 보내고 멈추는 편이 낫습니다. 자세한 기준은 API 에러 처리와 Rate Limit 대응을 참고하세요.
엔드포인트 원문과 증분 조회 설명은 API 문서의 통화 기록에 있습니다.
자주 묻는 질문
updatedAfter와 offset을 함께 쓰면 안 되나요?
KAT Cloud API 문서는 updatedAfter를 offset과 함께 쓰지 말라고 안내합니다. 조회 도중 갱신된 항목이 순서에 끼어들어 누락이 생길 수 있으므로, 응답 마지막 항목의 updatedAt을 다음 updatedAfter로 넘기는 커서만으로 이어 붙입니다.
방금 끝난 통화가 증분 조회에 보이지 않는 이유는 무엇인가요?
KAT Cloud 통화 기록의 updatedAt은 STT·요약 처리가 끝나 기록이 저장되는 시점에 갱신됩니다. 그래서 통화가 끝난 직후에는 증분 조회에 잡히지 않을 수 있고, 처리가 끝나면 요약·STT·녹음 정보가 채워진 상태로 조회됩니다.
웹훅과 증분 조회 중 무엇을 써야 하나요?
KAT Cloud API 문서는 통화 완료를 바로 받을 수 있는 CALL_COMPLETED 웹훅을 1순위로 권장하고, 웹훅을 쓰기 어려운 경우 updatedAfter 증분 조회를 권장합니다. 웹훅을 쓰는 경우에도 놓친 이벤트를 대조하는 용도로 증분 조회를 함께 돌릴 수 있습니다.
- #통화 기록
- #증분 동기화
- #updatedAfter
- #Python
- #KAT Cloud API