AI 전화 응답 지연은 어디서 생길까: 지연 예산 분해
AI 전화의 응답 지연은 네트워크 전송, 코덱과 지터 버퍼, 발화 종료 판단(VAD 엔드포인팅), 모델 추론, TTS 첫 음성 출력이 더해져 생깁니다. 구간별 원인과 줄이는 방향, 측정 방법을 정리했습니다.
AI 전화의 응답 지연은 고객이 말을 마친 순간부터 AI의 첫 음성이 고객 귀에 들릴 때까지 걸리는 시간이며, 한 곳이 아니라 여러 구간의 시간이 더해져 생깁니다. 전화망과 인터넷 구간의 전송, 코덱 처리와 지터 버퍼, 말이 끝났다고 판단하는 VAD 엔드포인팅, 모델 추론, TTS의 첫 음성 출력이 차례로 쌓입니다. 그래서 지연을 줄이려면 전체 시간을 구간별로 나누고 각 구간에 얼마를 쓸지 정하는 지연 예산으로 접근하는 것이 효과적입니다.
이 글은 구간마다 시간이 생기는 원리와 줄이는 방향을 개념 위주로 설명합니다. 특정 서비스의 측정값이 아니라 음성 AI 전화를 설계할 때 일반적으로 따져 보는 항목을 정리한 것입니다.
응답 지연은 어떻게 정의할까요
고객이 "대답이 늦다"고 느끼는 시간은 고객 발화가 끝난 시점부터 AI 음성의 첫 소리가 들리는 시점까지입니다. 응답 전체가 다 재생되는 시간보다 첫 소리가 언제 나오는지가 체감을 좌우합니다. 첫 문장만 빨리 나오면 나머지는 말하는 동안 이어서 만들어도 됩니다.
이 시간에는 왕복 경로가 모두 들어갑니다. 고객의 마지막 음성이 AI까지 가는 편도, AI가 판단하고 답을 만드는 처리 시간, AI의 첫 음성이 다시 고객에게 오는 편도입니다. 네트워크 구간은 한 번이 아니라 두 번 계산해야 합니다.
사람끼리의 대화에서는 상대가 말을 마친 뒤 대답이 시작되기까지의 공백이 대체로 매우 짧다고 알려져 있습니다. 전화에서는 표정이나 몸짓 같은 단서도 없으므로 공백이 길어지면 고객은 "듣고 있나?" 하고 같은 말을 반복하거나 AI 말에 끼어들게 되고, 대화가 꼬이기 시작합니다. 끼어들기를 다루는 방법은 말 끊기와 턴테이킹에서 이어서 설명합니다.
지연을 구간별로 나누면
응답 한 번이 만들어지는 경로를 순서대로 놓으면 아래와 같습니다.
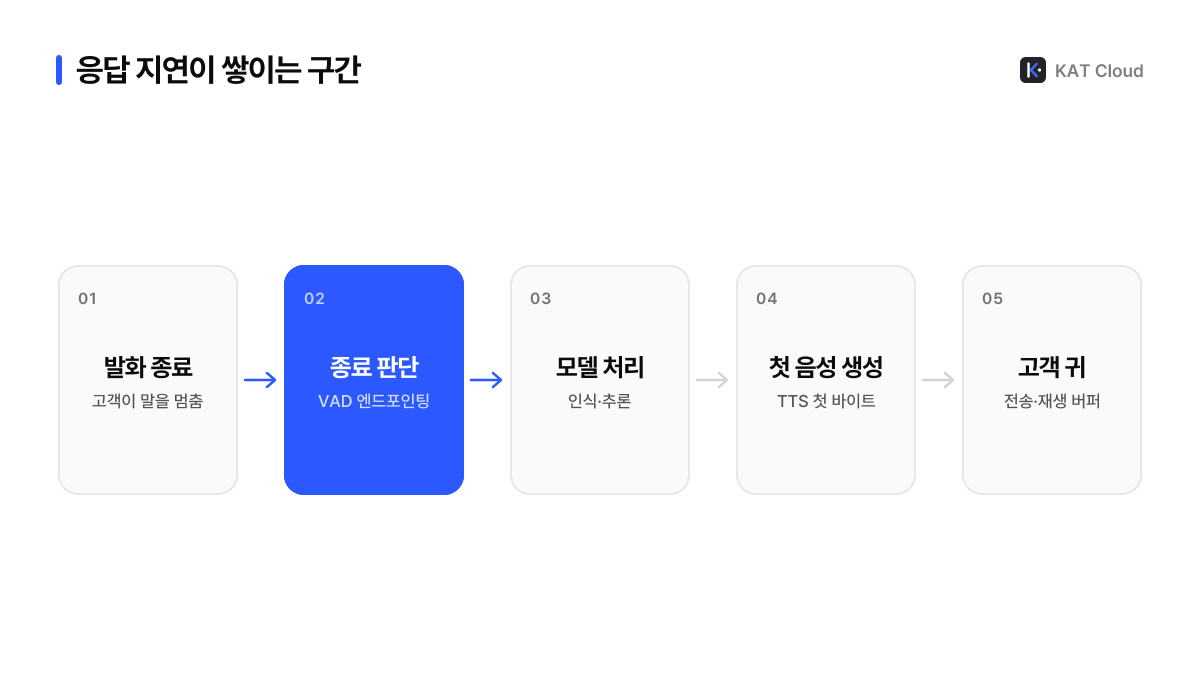
| 구간 | 시간이 생기는 이유 | 줄이는 방향 |
|---|---|---|
| 전화망·네트워크 전송 | 휴대폰에서 통신망, SIP·RTP 구간, 음성 AI 모델 서버까지의 거리와 거치는 장비 | 모델 서버와 가까운 경로, 불필요한 중계 줄이기 |
| 패킷화·코덱 | 음성을 일정 길이 프레임으로 묶어 보내고, 코덱 변환과 리샘플링이 더해짐 | 변환 횟수 최소화 |
| 지터 버퍼 | 도착 간격이 고르지 않은 패킷을 매끄럽게 재생하려고 잠시 모아 둠 | 네트워크 품질 확보, 적응형 버퍼 |
| VAD 엔드포인팅 | 말이 끝났다고 확신하려고 일정 시간 침묵을 기다림 | 침묵 기준 조정, 의미 기반 종료 판단 |
| 음성 인식 확정 | 연결형 구조에서 마지막 단어를 확정하는 처리 | 스트리밍 인식, 부분 결과 활용 |
| 모델 추론 | 첫 토큰이나 첫 음성까지의 계산, 긴 지침, 외부 도구 호출 | 지침 간결화, 조회 전 짧은 안내 |
| TTS 첫 바이트 | 첫 오디오 조각이 나오기까지의 합성 시간 | 문장 단위 스트리밍 합성 |
| 재생 측 버퍼 | 돌아가는 경로의 전송과 단말 재생 버퍼 | 전송 구간과 같은 원리 |
네트워크와 전화망
고객의 휴대폰 음성은 이동통신망과 전화망을 지나 SIP·RTP 구간으로 넘어오고, 다시 인터넷을 통해 음성 AI 모델 서버까지 갑니다. 모델 서버가 멀리 있을수록, 중간에 거치는 서버가 많을수록 편도 시간이 늘어납니다. 전화 품질 분야에서는 ITU-T G.114 권고가 대화형 음성의 편도 지연을 150ms 이내로 두는 것을 바람직한 기준으로 제시합니다. 이 기준은 사람끼리 통화할 때의 전송 지연을 다룬 것이므로, AI 전화에서는 여기에 AI 처리 시간이 더해진다는 점을 염두에 두어야 합니다.
코덱과 지터 버퍼
전화 음성은 보통 20ms 같은 짧은 프레임 단위로 RTP 패킷에 실려 오갑니다. 전화 구간에서 흔한 G.711은 8kHz 음성이고, 음성 AI 모델은 16kHz나 24kHz 음성을 받는 경우가 많아 중간에 리샘플링이 필요합니다. 변환이 여러 번 일어나면 시간과 음질 손실이 함께 쌓입니다. 코덱과 RTP의 기본은 RTP와 음성 코덱에 정리했습니다.
지터 버퍼는 네트워크 상태에 따라 패킷 도착 간격이 들쭉날쭉할 때 일정량을 모았다가 고르게 재생하는 장치입니다. 버퍼가 클수록 끊김은 줄지만 그만큼 지연이 늘어나므로, 네트워크 품질이 나쁜 구간이 있으면 버퍼가 커지면서 응답이 느리게 느껴질 수 있습니다.
VAD 엔드포인팅
엔드포인팅은 고객이 말을 마쳤는지 판단하는 단계로, 설정에 따라 지연이 가장 크게 달라지는 구간입니다. 침묵만 보고 판단하는 방식은 일정 시간 소리가 없어야 "끝났다"고 결론을 내리므로 그 대기 시간이 고스란히 지연이 됩니다. 기준을 너무 짧게 잡으면 고객이 숨을 고르는 사이에 AI가 끼어들고, 너무 길게 잡으면 매번 대답이 늦어집니다.
모델 추론과 TTS 첫 바이트
모델이 첫 토큰이나 첫 음성을 내기까지의 시간은 모델 자체, 응대 지침과 대화 이력의 길이, 외부 도구 호출 여부에 따라 달라집니다. 예약 조회처럼 외부 시스템을 부르는 순간에는 그 응답 시간이 그대로 더해집니다. 연결형 구조라면 그다음 TTS가 첫 오디오 조각을 내기까지의 시간도 더해지므로, 첫 문장을 짧게 만들수록 첫 소리가 빨리 나옵니다.
구조에 따라 달라지는 지연 예산
음성 AI 구조에 따라 예산을 나누는 방식도 달라집니다. 네트워크, 코덱, 발화 종료 판단은 어느 구조든 공통이고, 그 뒤가 다릅니다.
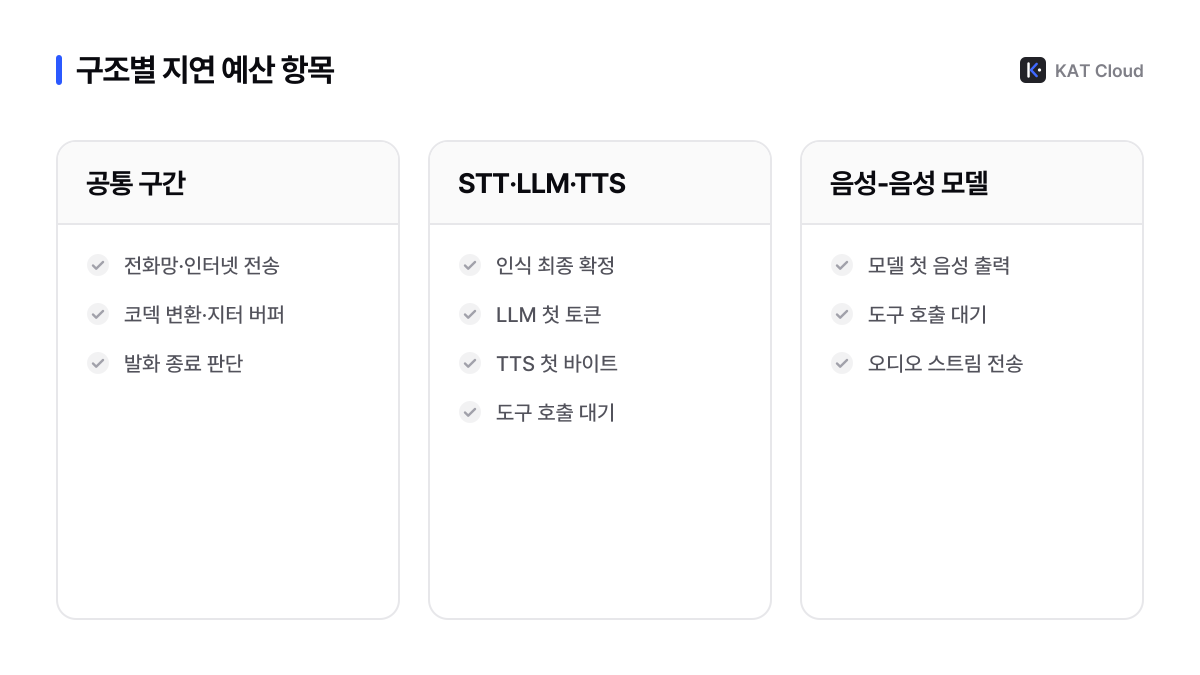
연결형 파이프라인은 단계가 많아 항목이 늘어나지만, 각 단계를 스트리밍으로 겹치면 실제 체감 시간은 단계 수만큼 늘지 않습니다. 음성-음성 모델은 항목이 적은 대신 모델 내부를 나눠 볼 수 없으므로 "발화 종료부터 첫 음성까지"를 한 덩어리로 측정합니다. 두 구조의 차이는 Speech-to-Speech vs STT·LLM·TTS에서 자세히 비교합니다.
지연을 줄이는 체크리스트
- 인식, 추론, 합성 모든 단계를 스트리밍으로 연결하고, 앞 단계가 끝나기를 기다리지 않게 합니다.
- 엔드포인팅 기준을 업무 단계마다 다르게 둡니다. 전화번호를 불러 주는 단계처럼 중간 쉼이 긴 구간은 기다림을 길게, "네·아니요" 확인 단계는 짧게 둡니다.
- 응대 지침과 대화 이력을 필요한 만큼만 유지합니다. 입력이 길수록 첫 응답까지의 계산이 늘어납니다.
- 외부 조회가 필요하면 조회를 시작하면서 "확인해 보겠습니다"처럼 짧게 먼저 말하게 합니다. 침묵 대신 소리가 있으면 같은 시간도 덜 길게 느껴집니다.
- 첫 문장을 짧게 쓰도록 지침을 둡니다. 첫 문장이 짧으면 TTS 첫 바이트가 빨라집니다.
- 코덱 변환과 리샘플링이 경로 중 몇 번 일어나는지 확인하고 줄입니다.
- 음성 AI 모델 서버까지의 경로가 불필요하게 멀거나 여러 번 중계되지 않는지 점검합니다.
지연을 측정하는 방법
지연은 실제 전화로 재야 합니다. 웹 데모나 노트북 마이크 시험에는 전화망 구간과 협대역 코덱 변환이 빠져 있어, 같은 모델이라도 전화에서는 다르게 느껴질 수 있습니다.
- 1시나리오를 나눕니다. 단순 질문에 대한 답, 외부 조회가 필요한 답, 긴 안내를 따로 측정해야 어느 구간이 문제인지 보입니다.
- 2자체 음성 서버를 SIP로 연결했다면 구간 경계마다 시각을 기록합니다. 마지막 음성 패킷 수신, 발화 종료 판정, 첫 토큰, 첫 오디오 송신 시각을 남기면 예산 표와 바로 비교할 수 있습니다.
- 3평균보다 분위수를 봅니다. 대부분 빠르더라도 가끔 길어지는 응답이 고객 경험을 결정하므로 중앙값과 상위 구간 값을 함께 확인합니다.
- 4녹음으로 공백을 들어 봅니다. 통화 녹음에서 고객 말이 끝난 지점과 AI 음성이 시작된 지점 사이를 파형으로 재 볼 수 있습니다. 다만 녹음 위치에 따라 고객 쪽 전송 구간은 빠질 수 있다는 점을 감안합니다.
- 5모델을 바꿔 같은 시나리오를 반복합니다. KAT Cloud에서는 음성 모델 선택을 콘솔에서 설정하므로, 후보 모델별로 시험 통화를 나눠 비교할 수 있습니다. 비교 순서는 음성 AI 모델 고르는 법을 참고하세요.
자주 묻는 질문
AI 전화 응답 지연에서 가장 큰 비중을 차지하는 구간은 어디인가요?
AI 전화 응답 지연에서 구간별 비중은 구성마다 다르지만, 발화 종료 판단(VAD 엔드포인팅), 모델 추론, TTS 첫 음성 출력이 큰 비중을 차지하는 경우가 많습니다. 특히 엔드포인팅은 설정값에 따라 크게 달라지므로 먼저 점검할 만합니다. 정확한 비중은 실제 통화에서 구간별 시각을 기록해 확인해야 합니다.
응답 지연은 무조건 짧을수록 좋은가요?
응답 지연은 짧을수록 대화가 자연스럽지만, 발화 종료 판단을 지나치게 짧게 잡으면 고객이 잠깐 숨을 고를 때 AI가 끼어드는 문제가 생깁니다. 지연과 오판 사이의 균형을 업무 단계에 맞게 조정하는 것이 중요합니다.
KAT Cloud로 연결한 AI 전화의 지연은 무엇에 따라 달라지나요?
KAT Cloud로 연결한 AI 전화의 응답 지연은 선택한 음성 AI 모델, 고객의 통신 환경, 응대 지침의 길이, 외부 시스템 조회 여부에 따라 달라지므로 하나의 숫자로 말하기 어렵습니다. 콘솔에서 모델을 바꿔 가며 같은 시나리오로 시험 통화를 해 보고 체감 지연을 비교하는 것이 가장 정확합니다.
- #응답 지연
- #음성 AI
- #VAD
- #지터 버퍼
- #레이턴시