Speech-to-Speech vs STT·LLM·TTS: 음성 AI 구조 비교
음성 AI 에이전트는 음성을 듣고 바로 음성으로 답하는 Speech-to-Speech 모델과 STT·LLM·TTS를 차례로 잇는 파이프라인 두 구조로 나뉩니다. 동작 방식, 장단점, 전화 AI에서 고르는 기준을 정리했습니다.
음성 AI 에이전트의 구조는 크게 두 가지입니다. Speech-to-Speech(음성-음성) 모델은 하나의 모델이 고객의 음성을 듣고 곧바로 음성으로 답하는 구조이고, STT·LLM·TTS 파이프라인은 음성 인식(STT), 언어 모델(LLM), 음성 합성(TTS) 세 단계를 차례로 이어 붙인 구조입니다. 두 구조는 어느 한쪽이 늘 낫다기보다 응답이 만들어지는 경로, 제어 방식, 문제를 찾는 방법이 다르므로 전화 업무의 성격에 맞춰 고르는 것이 좋습니다.
이 글은 두 구조가 각각 어떻게 동작하는지, 전화 환경에서 어떤 차이가 생기는지, 그리고 KAT Cloud(캣클라우드)에서 두 구조를 어떤 방식으로 쓸 수 있는지 정리합니다.
두 구조를 한눈에 비교하면
두 구조의 가장 큰 차이는 "응답을 만드는 동안 텍스트를 거치는가"입니다. 파이프라인은 음성을 먼저 글자로 바꾸고, 글자로 답을 만든 뒤, 다시 음성으로 바꿉니다. 음성-음성 모델은 이 과정을 모델 하나가 내부에서 처리하므로 중간에 사람이 읽을 수 있는 텍스트가 꼭 생기지는 않습니다.
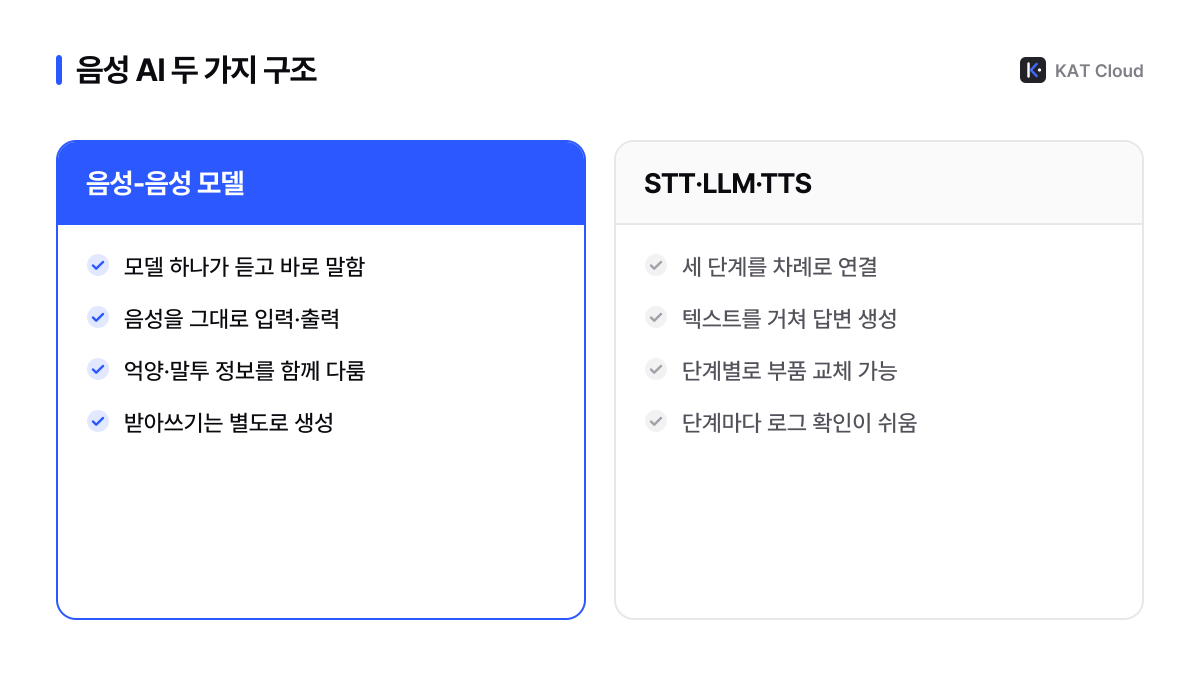
| 비교 항목 | Speech-to-Speech 모델 | STT·LLM·TTS 파이프라인 |
|---|---|---|
| 구성 | 음성을 입력받아 음성을 내보내는 모델 하나 | 음성 인식, 언어 모델, 음성 합성 세 부품 |
| 중간 결과물 | 내부 표현으로 처리, 텍스트는 필요할 때 따로 생성 | 단계마다 텍스트가 생김 |
| 시간이 쌓이는 곳 | 발화 종료 판단과 모델의 첫 음성 출력 | 세 단계의 처리 시간과 단계 사이 전달 |
| 억양·감정 정보 | 말의 높낮이, 속도, 망설임을 함께 다룸 | 텍스트로 바뀌면서 대부분 사라짐 |
| 부품 교체 | 모델 단위로 교체 | 인식·언어·합성을 각각 교체 |
| 문제 찾기 | 입력·출력 음성과 받아쓰기로 확인 | 어느 단계에서 틀렸는지 텍스트로 추적 |
STT·LLM·TTS 파이프라인은 이렇게 동작합니다
파이프라인은 캐스케이드(연결형) 구조라고도 부릅니다. 전화 한 통에서 고객이 한 번 말할 때마다 아래 세 단계가 차례로 돌아갑니다.
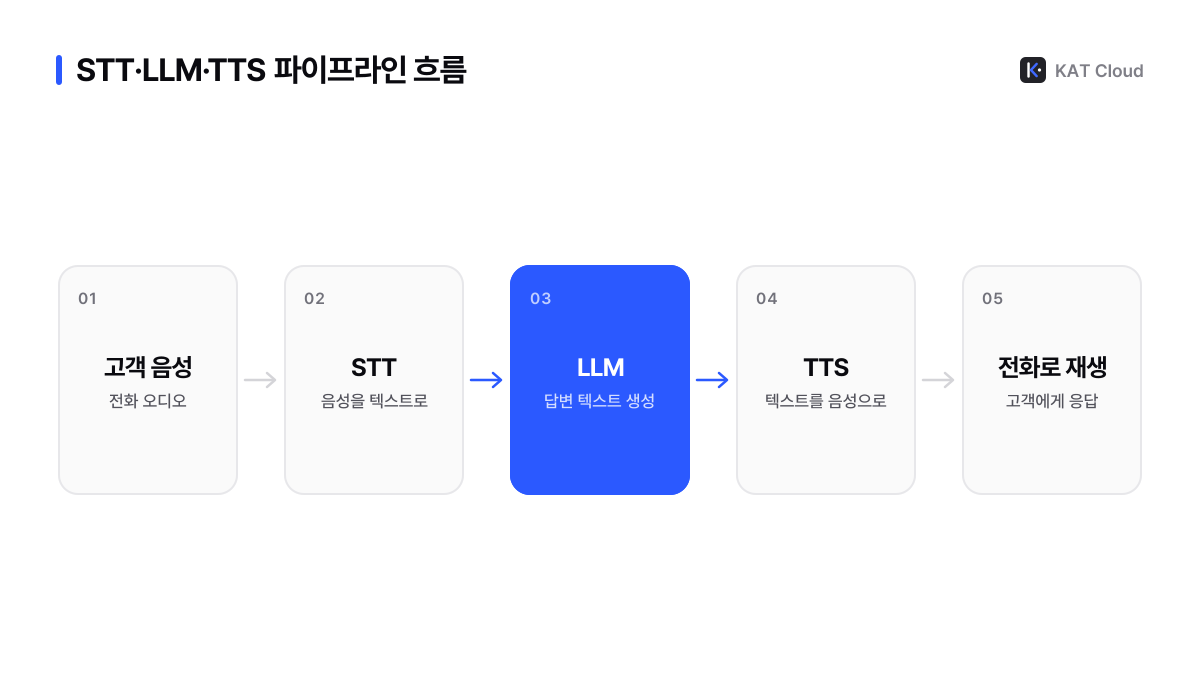
- 1음성 인식(STT)이 전화 음성을 텍스트로 바꿉니다. 실시간 대화에서는 말이 끝나기를 기다리지 않고 부분 결과를 계속 내보내는 스트리밍 방식을 주로 씁니다.
- 2언어 모델(LLM)이 받아쓴 문장과 대화 이력, 응대 지침을 바탕으로 답변 텍스트를 만듭니다. 예약 조회처럼 외부 시스템을 호출하는 일도 보통 이 단계에서 일어납니다.
- 3음성 합성(TTS)이 답변 텍스트를 음성으로 바꿔 통화로 내보냅니다. 문장 전체를 기다리지 않고 앞부분부터 합성해 보내는 방식이 일반적입니다.
파이프라인의 장점은 각 부품을 따로 고르고 따로 고칠 수 있다는 점입니다. 한국어 전화 음성에 맞는 인식 엔진, 원하는 언어 모델, 브랜드에 맞는 목소리를 조합할 수 있고, 중간에 텍스트가 있으므로 금지어 걸러 내기, 개인정보 가리기, 정해진 안내 문구 그대로 읽기 같은 규칙을 적용하기 쉽습니다. 문제가 생겼을 때 "잘못 들었는지, 잘못 답했는지, 잘못 읽었는지"를 로그로 가려낼 수 있다는 점도 운영에서 큰 이점입니다.
반대로 단계가 늘어날수록 각 단계의 처리 시간과 단계 사이의 전달 시간이 더해집니다. 그래서 파이프라인은 세 단계를 최대한 겹쳐서 스트리밍으로 처리하는 설계가 중요합니다. 또 음성이 텍스트로 바뀌는 순간 말투, 감정, 망설임 같은 정보가 대부분 사라지고, 고객이 말을 끝냈는지 판단하는 일과 말 끊기 처리도 별도로 설계해야 합니다. 지연이 어느 구간에서 생기는지는 AI 전화 응답 지연 분해에서 자세히 다룹니다.
Speech-to-Speech 모델은 무엇이 다른가요
음성-음성 모델은 오디오 스트림을 입력으로 받아 오디오 스트림을 바로 출력합니다. 보통 실시간 API 형태로 제공되며, 통화 동안 세션을 열어 두고 양쪽 음성을 계속 주고받습니다.
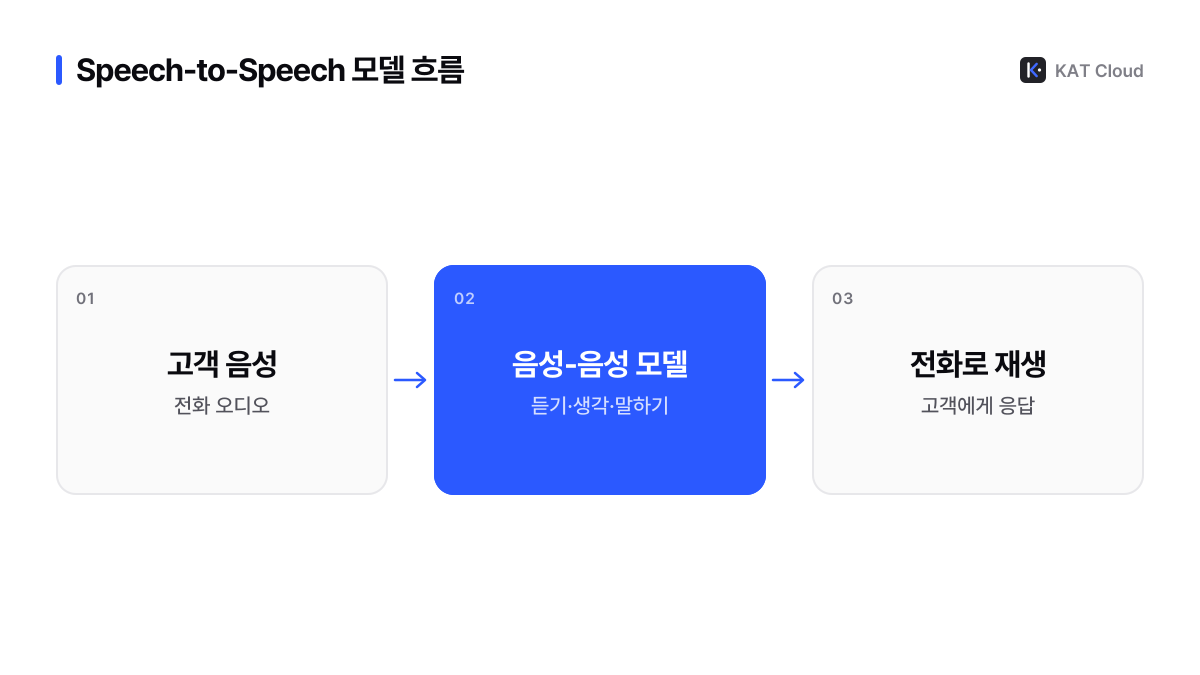
이 구조의 장점은 부품 사이를 오가는 단계가 적다는 것입니다. 고객의 억양, 말 속도, 웃음이나 머뭇거림 같은 신호를 입력으로 그대로 쓰고, 출력 음성에도 자연스러운 운율을 담을 수 있습니다. 많은 실시간 모델이 음성 활동 감지와 끼어들기 처리를 함께 제공하므로 대화 흐름을 비교적 적은 설정으로 만들 수 있습니다.
단점도 분명합니다. 중간 텍스트가 없거나 제한적이어서 "왜 그렇게 답했는지"를 추적하기가 파이프라인보다 어렵습니다. 약관 안내나 녹음 고지처럼 문구를 정확히 지켜야 하는 부분은 응대 지침으로 통제해야 하고, 인식 엔진이나 목소리만 따로 바꾸는 것은 어려워 모델 단위로 교체하게 됩니다. 대화 기록이 필요하면 받아쓰기를 별도로 만들어야 합니다.
두 구조 사이의 중간 형태도 있습니다. 음성을 직접 입력받아 텍스트로 답하고 그 텍스트를 TTS로 읽는 구조처럼, 일부 단계만 합친 방식도 쓰입니다. 실제 제품을 고를 때는 이름보다 "어디까지가 한 모델이고 어디부터 따로 연결되는지"를 확인하는 편이 정확합니다.
전화 환경에서 달라지는 점
전화는 두 구조 모두에게 까다로운 환경입니다. 일반 전화 구간의 음성은 8kHz 협대역으로 오가는 경우가 많아 모델이 학습한 깨끗한 음성보다 정보가 적고, 화면이 없으니 고객은 오로지 소리로만 대화의 차례를 판단합니다.
- 침묵이 길어지면 고객은 통화가 끊겼다고 느끼므로, 외부 조회가 필요한 순간에는 "확인해 보겠습니다" 같은 짧은 안내가 필요합니다.
- 고객이 AI 말 중간에 끼어드는 일이 잦으므로 말 끊기를 어떻게 처리하는지가 체감 품질을 크게 좌우합니다. 자세한 내용은 말 끊기와 턴테이킹을 참고하세요.
- 전화번호, 날짜, 주소처럼 정확해야 하는 정보는 구조와 관계없이 되읽어 확인하는 대화 설계가 필요합니다.
- 파이프라인은 전화 음성에 강한 인식 엔진을 골라 끼울 수 있고, 음성-음성 모델은 모델 자체가 전화 음성을 얼마나 잘 다루는지 시험으로 확인해야 합니다.
KAT Cloud에서 두 구조를 쓰는 방법
KAT Cloud는 통화 음성을 음성 AI 모델과 양방향 실시간으로 연결하는 AI 전화 통신 인프라입니다. 두 구조를 쓰는 길은 크게 두 가지입니다.
- KAT Cloud의 음성 AI 모델 연결: 14종 음성 AI 모델 중 하나를 골라 AI 에이전트에 연결합니다. 모델 선택과 응대 지침은 KAT Cloud 콘솔에서 설정합니다. 14종에는 실시간 음성 API 계열 모델과, 음성 인식·합성 전문 회사가 여러 단계를 묶어 제공하는 에이전트 제품이 함께 있으며, 모델별 내부 구조는 각 제공사 문서에서 최신 내용을 확인하는 것이 정확합니다.
- 직접 만든 음성 서버 연결: STT·LLM·TTS를 원하는 조합으로 구성한 내 음성 서버를 표준 SIP/2.0·RTP·DTMF로 KAT Cloud 회선에 연결합니다. SIP 직접 연결은 모든 플랜에서 무료이고, SIP 접속 정보는 콘솔 또는 도입 문의로 안내받습니다.
모델별 제공사와 분당 요금은 음성 AI 모델 14종 한눈에 보기에 정리했습니다. 처음에는 콘솔에서 모델을 바꿔 가며 같은 시나리오로 시험해 보고, 부품 단위 제어가 꼭 필요할 때 직접 구성으로 넘어가는 순서가 부담이 적습니다.
어떤 구조를 고를까요
아래 기준으로 업무를 점검하면 출발점을 정하기 쉽습니다.
- 정해진 문구를 정확히 읽어야 하는 안내가 많다면 텍스트 단계에서 통제하기 쉬운 파이프라인이 유리할 수 있습니다.
- 대화의 자연스러움과 짧은 응답 흐름이 중요하다면 음성-음성 모델을 먼저 시험해 볼 만합니다.
- 인식 엔진, 언어 모델, 목소리를 각각 고르고 싶다면 파이프라인을 직접 구성하거나 묶음형 에이전트 제품을 검토합니다.
- 운영 인력이 적고 빨리 시작해야 한다면 콘솔에서 모델을 고르는 방식이 설정할 것이 적습니다.
- 어떤 경우든 최종 판단은 실제 휴대폰으로 건 시험 통화로 합니다. 시험 방법과 예산 계산은 음성 AI 모델 고르는 법을 참고하세요.
자주 묻는 질문
Speech-to-Speech 모델은 STT를 전혀 쓰지 않나요?
Speech-to-Speech 모델은 응답을 만들 때 음성을 텍스트로 바꾸는 별도 STT 단계를 거치지 않고 음성을 직접 다룹니다. 다만 대화 기록이나 분석을 위해 받아쓰기 텍스트를 따로 만드는 경우가 많으며, KAT Cloud에서는 통화가 끝난 뒤 AI 받아쓰기와 요약 결과를 통화 기록으로 받을 수 있습니다.
STT·LLM·TTS 파이프라인은 항상 더 느린가요?
STT·LLM·TTS 파이프라인이 항상 더 느린 것은 아닙니다. 세 단계를 스트리밍으로 겹쳐 처리하면 체감 지연을 줄일 수 있고, 실제 응답 속도는 모델, 네트워크 경로, 발화 종료 판단 설정에 따라 달라집니다. 구조만으로 판단하지 말고 실제 전화로 비교하는 것이 정확합니다.
KAT Cloud에서 두 구조를 모두 쓸 수 있나요?
KAT Cloud에서는 콘솔에서 14종 음성 AI 모델 중 하나를 골라 AI 에이전트에 연결할 수 있고, 직접 만든 STT·LLM·TTS 음성 서버를 표준 SIP로 연결해 쓸 수도 있습니다. SIP 직접 연결은 모든 플랜에서 무료입니다.
- #음성 AI
- #Speech-to-Speech
- #STT
- #TTS
- #음성 에이전트