전화 음성 인식이 어려운 이유: 협대역 음성, 잡음, 한국어 특성
전화 음성 인식이 어려운 이유는 8kHz 협대역 음성, 통화 잡음, 한국어 조사·어미 변화, 숫자·주소 표현, 업종별 전문 용어 때문입니다. 원인별로 생기는 오류와 대화 설계로 줄이는 방법을 정리했습니다.
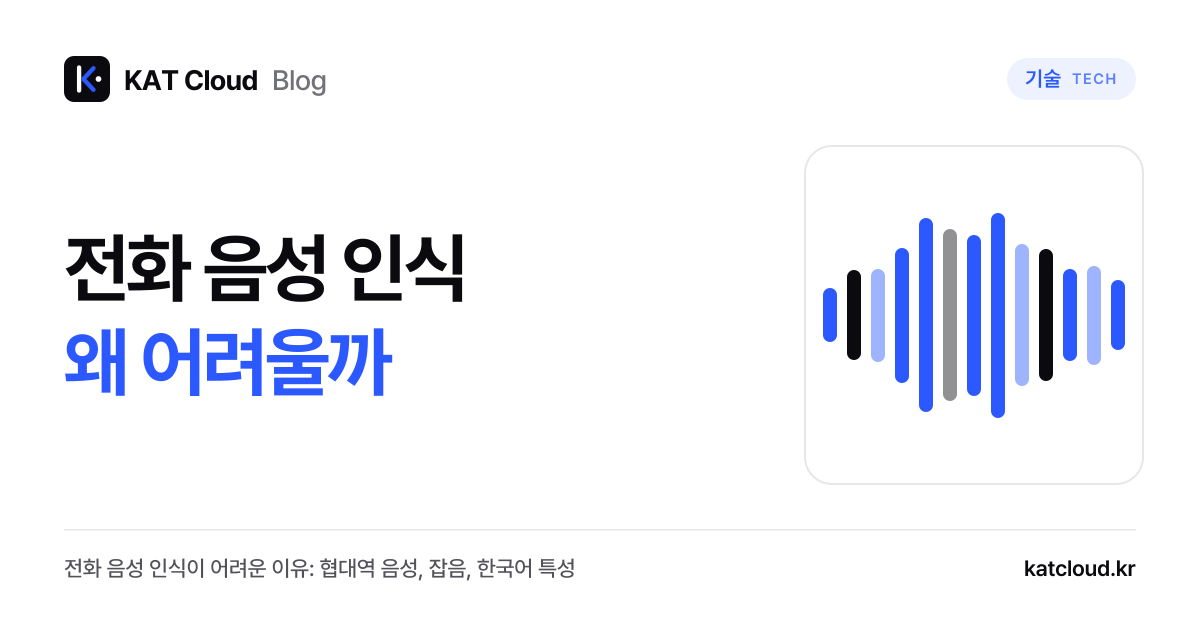
전화 음성 인식이 어려운 이유는 전화망이 사람 목소리의 일부 대역만 전달하고(8kHz 협대역), 통화 환경의 잡음과 압축 손실이 더해지며, 한국어 특유의 조사·어미 변화와 숫자·주소 표현이 오류를 키우기 때문입니다. 같은 음성 인식 모델이라도 마이크로 녹음한 깨끗한 음성보다 전화 음성에서 결과가 나빠지는 일이 흔합니다. 이 글은 원인을 다섯 가지로 나누고, 각각을 모델 선택과 대화 설계로 어떻게 줄일 수 있는지 정리합니다.
협대역 8kHz 음성: 소리의 일부만 도착합니다
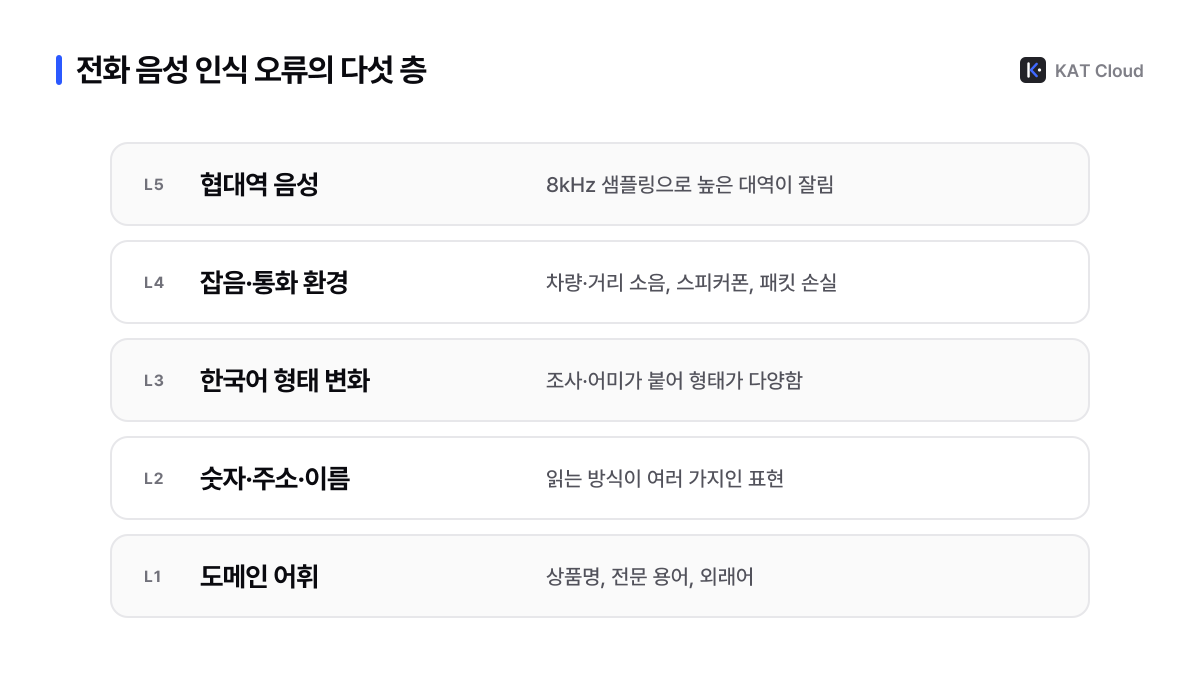
일반 유선 전화와 많은 SIP 구간은 G.711 코덱으로 8kHz 샘플링 음성을 주고받습니다. 8kHz 샘플링은 이론상 4kHz까지 표현할 수 있고, 실제 전화 음성 대역은 대략 300~3,400Hz입니다. 사람 목소리에는 이보다 높은 주파수 성분도 많아서 전화로는 그 부분이 아예 전달되지 않습니다.
잘려 나가는 높은 대역에는 ㅅ, ㅆ, ㅈ, ㅊ, ㅎ 같은 마찰음과 파찰음을 구분하는 단서가 많이 담겨 있습니다. 그래서 전화 음성에서는 비슷한 자음끼리 헷갈리는 오류가 늘고, 숫자 '일'과 '이'처럼 짧고 비슷한 음절도 틀리기 쉽습니다.
휴대폰끼리 고음질 통화(VoLTE HD)를 할 때는 광대역 코덱을 쓰지만, 다른 망을 거치거나 SIP 트렁크로 넘어가는 과정에서 협대역으로 바뀌는 경우가 많습니다. 많은 음성 인식 모델은 16kHz 이상의 음성으로 학습되므로, 8kHz 음성을 16kHz로 리샘플링해 넣더라도 이미 사라진 대역까지 되살아나지는 않습니다. 코덱과 샘플링의 기본은 RTP와 음성 코덱에서 자세히 설명합니다.
잡음과 통화 환경
고객은 조용한 방에서만 전화하지 않습니다. 운전 중, 길거리, 음악이 나오는 매장, TV가 켜진 거실에서 전화를 겁니다. 전화 음성 인식에 영향을 주는 환경 요인은 다음과 같습니다.
- 배경 소음과 다른 사람 목소리: 주변 대화나 TV 소리를 고객 발화로 받아쓰기도 합니다.
- 스피커폰: 입과 마이크 사이가 멀어 울림이 커지고, AI 음성이 되돌아오는 반향이 생길 수 있습니다.
- 패킷 손실: 인터넷 구간에서 음성 패킷이 빠지면 단말이나 서버가 빈 부분을 메우는데, 이 과정에서 음절이 뭉개집니다.
- 단말의 잡음 억제: 휴대폰의 잡음 제거 기능이 목소리 일부까지 깎아 내는 경우가 있습니다.
- 발화 특성: 작은 목소리, 빠른 말, 사투리, 어르신의 발음은 학습 데이터에 상대적으로 적을 수 있습니다.
환경 자체는 바꿀 수 없으므로, 인식이 불확실할 때 되묻는 지침과 짧은 질문으로 대화를 나누는 설계가 현실적인 대응입니다.
한국어 조사와 어미
한국어는 명사 뒤에 조사가, 동사 뒤에 어미가 붙어 같은 단어도 형태가 다양해집니다. 이 특성은 인식 자체보다 인식 결과를 업무에 쓰는 단계에서 문제를 일으키는 경우가 많습니다.
| 현상 | 예시 | 생길 수 있는 문제 |
|---|---|---|
| 조사 변화 | 예약을, 예약은, 예약도, 예약이요 | 키워드를 그대로 찾는 규칙이 놓침 |
| 어미가 의미를 결정 | 취소할게요, 취소할까요, 취소 안 할게요 | 끝부분이 작게 들리면 뜻이 뒤집힘 |
| 짧은 응답 | 네, 예, 아니요, 아뇨 | 잡음에 묻히거나 서로 바뀌어 인식 |
| 띄어쓰기 차이 | 안돼요, 안 돼요 | 같은 말이 다른 문자열로 저장 |
| 연결 어미 | 주문했는데요, 그런데요 | 문장이 끝났다고 오판 |
특히 문장 끝의 어미는 소리가 작아지거나 빨라지기 쉬운데, 한국어에서는 바로 그 부분이 통보인지 질문인지, 긍정인지 부정인지를 정합니다. 예약 취소나 결제처럼 되돌리기 어려운 결정은 "예약을 취소할까요?"처럼 AI가 한 번 더 확인하고 고객의 명확한 대답을 받은 뒤 진행하도록 설계하는 것이 안전합니다. 받아쓴 텍스트를 내 시스템에서 처리할 때는 띄어쓰기와 조사를 걷어 낸 형태로 정규화하거나, 정확한 문자열 일치 대신 의미 단위로 분류하는 편이 견고합니다.
숫자·주소·이름
전화 업무에서 가장 중요한 정보는 대개 숫자입니다. 그런데 한국어 숫자는 읽는 방식이 여러 가지입니다.
- 한자어 수(일, 이, 삼)와 고유어 수(하나, 둘, 셋)가 섞입니다. "세 시 삼십 분"에는 두 체계가 함께 들어 있습니다.
- 0을 "공" 또는 "영"으로 읽고, 전화번호는 "공일공에 이삼사오에"처럼 덩어리로 끊어 부릅니다.
- 같은 숫자도 "천이백삼"과 "일이공삼"처럼 자리를 읽거나 한 자씩 읽습니다. 아파트 동·호수가 대표적입니다.
- 주소는 도로명과 지번이 섞이고, 비슷한 동 이름이 많습니다.
- 이름은 동음이의가 많고, 영문과 숫자가 섞인 주문번호는 더 어렵습니다.
숫자는 인식만으로 해결하려 하기보다 대화 구조로 보완하는 것이 효과적입니다.
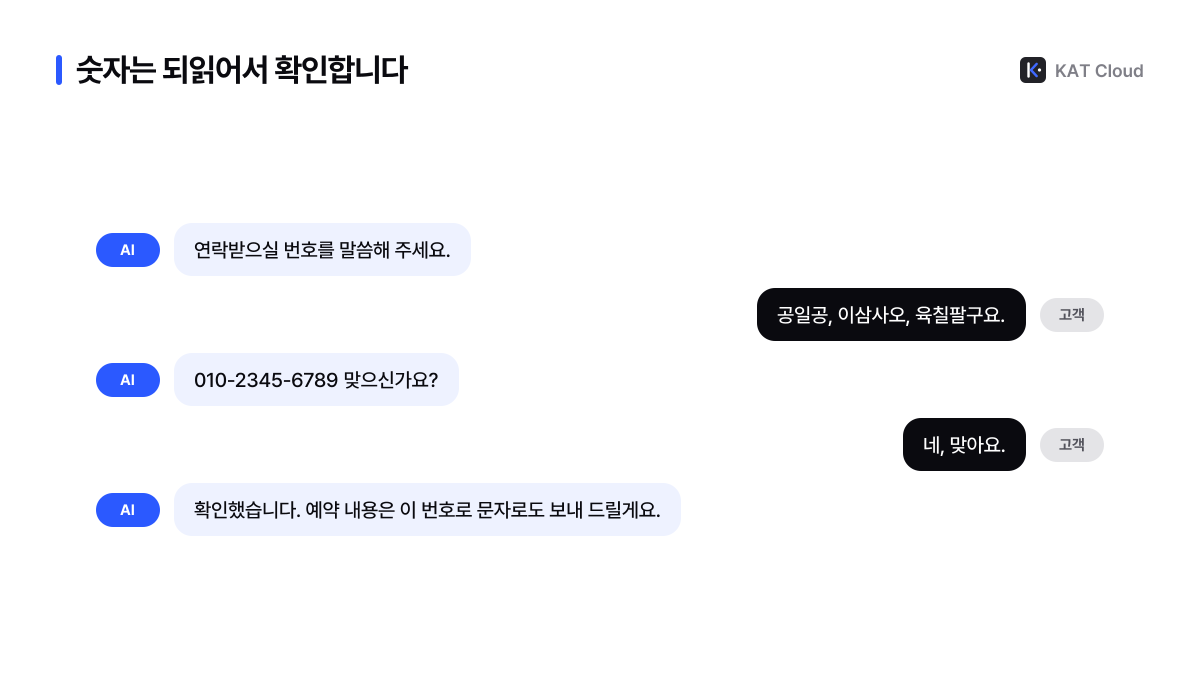
- 1받은 숫자는 되읽어서 확인합니다.
- 2긴 번호는 덩어리로 나눠 묻습니다.
- 3정확해야 하는 숫자는 키패드(DTMF)로 받는 방법도 있습니다. 자세한 내용은 DTMF 설명을 참고하세요.
- 4발신 번호는 통화 기록에 이미 남으므로, 같은 번호로 연락해도 되는지만 물으면 번호를 다시 받지 않아도 됩니다.
- 5통화가 끝나면 접수 내용을 문자로 보내 고객이 한 번 더 확인하게 합니다. KAT Cloud는 통화와 같은 번호로 문자를 보낼 수 있습니다.
도메인 어휘
업종마다 일반 대화에 잘 나오지 않는 단어가 있습니다. 병원의 시술명과 약품명, 쇼핑몰의 상품명과 옵션명, 학원의 과목명, 영어 약어와 신조어가 대표적입니다. 범용 인식 모델은 처음 듣는 단어를 소리가 비슷한 흔한 단어로 바꿔 적는 경향이 있습니다.
- 모델이나 제공사가 지원하는 경우 키워드나 용어 힌트 기능을 씁니다.
- 응대 지침에 자주 쓰는 용어 목록과 설명을 넣어 둡니다.
- 받아쓴 텍스트를 후처리할 때 자주 틀리는 표기를 정식 명칭으로 바꾸는 사전을 둡니다.
- 쌓인 통화 기록에서 반복되는 오류를 찾아 사전과 지침을 고칩니다.
KAT Cloud에서 인식 품질을 점검하는 방법
KAT Cloud에서는 음성 AI 모델 선택을 콘솔에서 설정하므로, 같은 시나리오를 후보 모델별로 시험 통화해 비교할 수 있습니다. 시험은 반드시 실제 휴대폰으로, 조용한 곳과 시끄러운 곳 모두에서 합니다.
녹음이 켜진 통화는 끝난 뒤 AI 구간 대화(sttAI)와 직원 구간 대화(sttDirect)를 통화 기록으로 받을 수 있습니다. 고객이 실제로 한 말과 받아쓰기를 녹음과 비교하면 어떤 단어와 숫자에서 오류가 반복되는지 보입니다. 데이터 구조는 통화 받아쓰기와 요약 데이터 구조에, 모델을 고르는 순서는 음성 AI 모델 고르는 법에 정리했습니다.
자주 묻는 질문
전화 음성을 16kHz로 바꾸면 인식이 좋아지나요?
8kHz 전화 음성을 16kHz로 리샘플링해도 전화망에서 이미 잘려 나간 높은 대역은 복원되지 않습니다. 리샘플링은 모델 입력 형식을 맞추는 용도이며, 인식 결과를 높이려면 전화 음성에서 직접 시험해 검증한 모델을 고르고 되묻기 같은 대화 설계를 함께 쓰는 편이 효과적입니다.
전화번호나 주소를 잘못 알아듣는 문제는 어떻게 줄이나요?
전화번호와 주소 오류는 인식 모델만으로 없애기 어렵기 때문에 대화 구조로 보완합니다. 받은 숫자를 되읽어 확인하고, 긴 번호는 나눠 묻고, 정확해야 하는 숫자는 키패드(DTMF)로 받고, 통화 후 접수 내용을 문자로 보내 고객이 다시 확인하게 하는 방법을 함께 씁니다.
KAT Cloud에서 인식 오류를 확인할 수 있나요?
KAT Cloud에서는 녹음이 켜진 통화가 끝나면 AI 구간(sttAI)과 직원 구간(sttDirect)의 받아쓰기를 CALL_COMPLETED 웹훅이나 통화 기록 API로 받을 수 있습니다. 이 텍스트를 녹음과 비교하면 반복되는 인식 오류를 찾아 응대 지침과 후처리 사전을 고칠 수 있습니다.
- #음성 인식
- #STT
- #협대역
- #한국어 음성 인식
- #전화 음성